Все, кто смогли ответить на вызовы времени – герои!
Завершается приём заявок на участие в «Евразийской премии «Ассамблеи автомобилистов». Она пройдёт во второй раз и финиширует торжественным чествованием победителей 18 ноября 2026 года в Петербурге.
Весь широкий круг автомобильный индустрии, примите мои поздравления! Вы пережили такой шторм, какого ещё не было на российском авторынке. За несколько лет под вопрос было поставлено буквально всё: привычные марки автомобилей и компонентов, бензин и смазки, дилерские контракты и сервисные станции, цепочки поставок и партнерские связи. Все, кто смогли ответить на эти вызовы, все вы – герои!
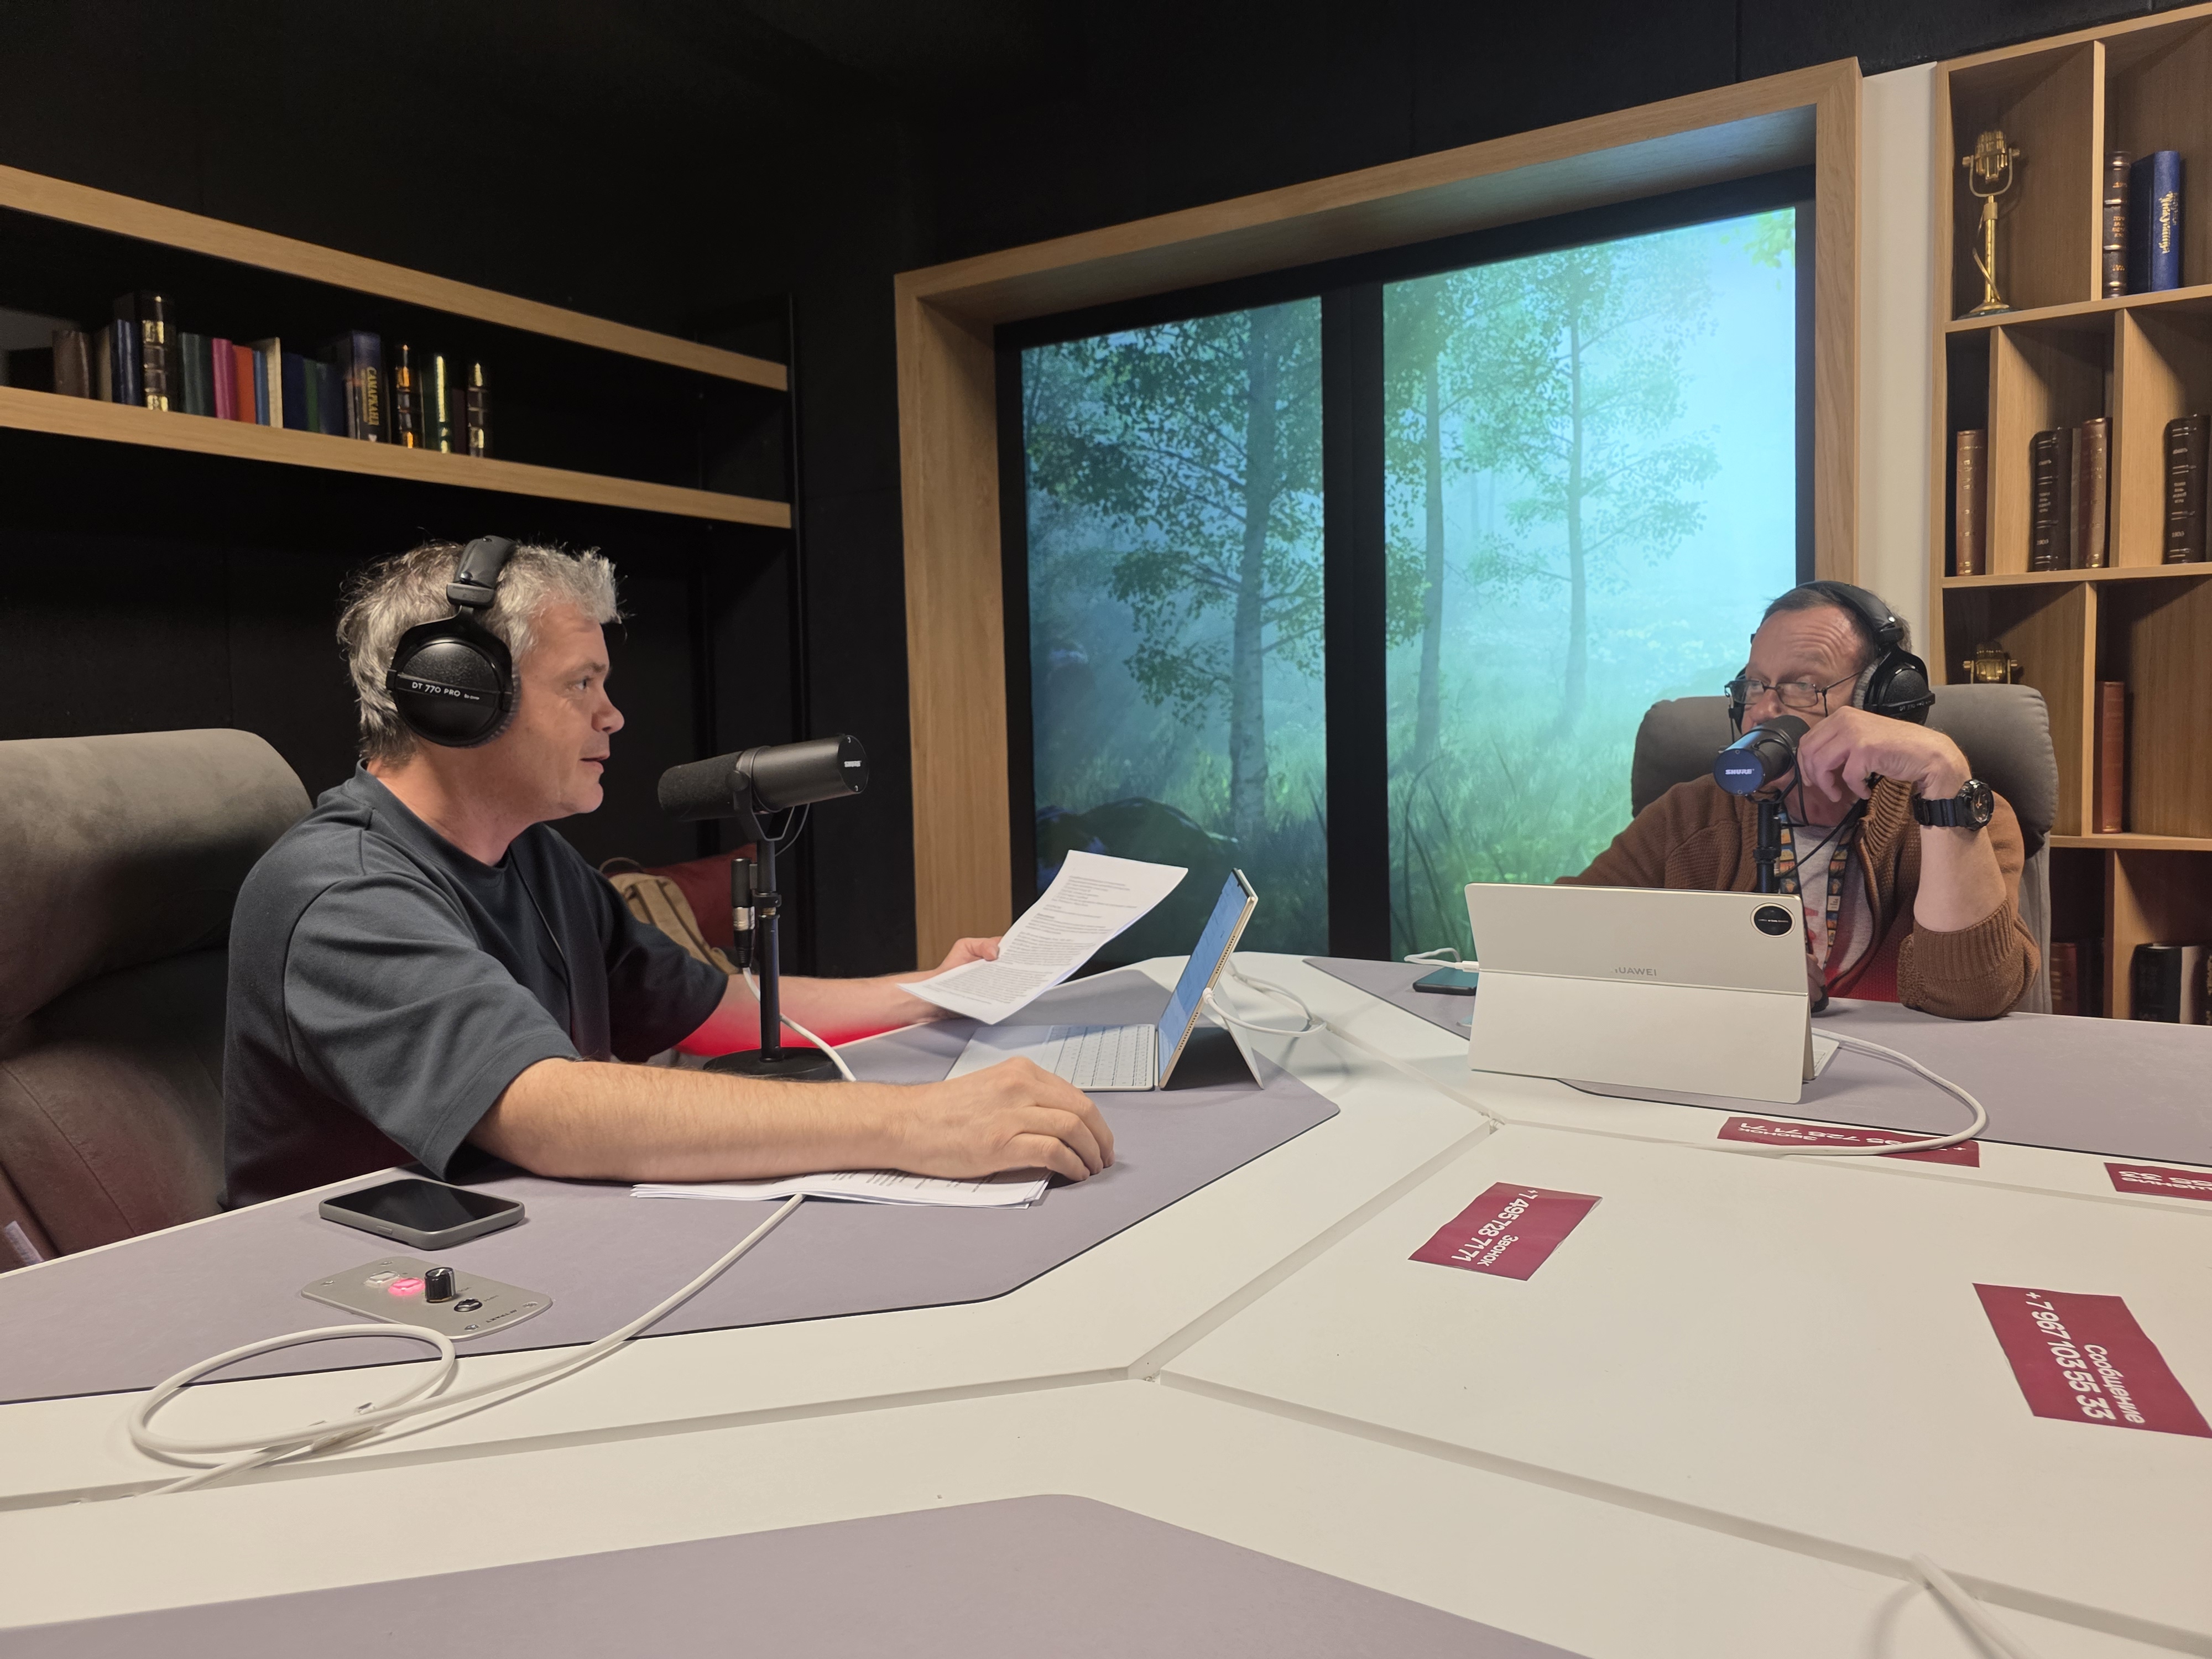
В числе выживших и нашедших свое место в новой реальности – Ассамблея автомобилистов. На протяжении более 10 лет — это наиболее значимая площадка для обсуждения автомобилей и всего, что их окружает, с широкой аудиторией федеральных СМИ. Коллектив авторов уделяет особое внимание участникам «Евразийской премии «Ассамблеи автомобилистов», героям автомобильной отрасли. Если Вы один из них, и Вам есть что сказать, – познакомьтесь с нами и приходите к нам в радиоэфиры!
Подробности на сайте https://www.ep.autoassa.ru/


Start with expected behavior, allowed variation and the condition that should fail the case, then keep retrieval, reasoning, formatting and tool execution results separate so a team can locate the regression. https://ai-software-development.net
A <a href=https://ai-software-development.net>production AI testing strategy</a> also needs fixed comparison data for model or prompt changes. Human review is useful for disputed cases, but reviewers need the same rubric. Otherwise the evaluation measures reviewer preference rather than product behavior.